Tout logiciel SaaS fait la même promesse : vos données sont rangées à côté de celles d'autres clients, et ces clients ne les verront jamais. Cet article explique comment cette promesse est tenue, où elle casse, et ce que les plus gros produits du web font pour la tenir.
English version: One database, a thousand customers, zero leaks.
Deux fuites à garder en tête
En septembre 2026, un chercheur en sécurité démarre un conteneur chez Cloudflare et lit ce que l'occupant précédent a laissé sur le disque. Le pool de stockage distribuait des blocs de 64 Kio sans les effacer : une écriture de 4 Kio réservait un bloc qui contenait encore jusqu'à 60 Kio des données de quelqu'un d'autre, listes de répertoires, pages de bases de données, bases SQLite complètes d'autres clients. Des restes de données sont apparus sur 18 des 24 placements testés, sur 20 des 22 hôtes, sur quatre continents. Cloudflare a corrigé en trois jours et n'a trouvé aucune trace d'exploitation (compte rendu de Cloudflare, septembre 2026).
En mars 2023, des utilisateurs de ChatGPT voient des titres de conversations qui ne sont pas les leurs. La cause est un bug dans redis-py, la bibliothèque cliente Redis : quand une requête était annulée après sa mise en file mais avant la lecture de sa réponse, la connexion restait corrompue et la réponse suivante partait vers une requête sans rapport. OpenAI a aussi établi que le même bug a pu exposer, pour 1,2 % des abonnés Plus actifs pendant une fenêtre de neuf heures, le nom, l'e-mail, l'adresse de facturation, le type de carte, les quatre derniers chiffres et la date d'expiration d'un autre utilisateur (rapport d'incident OpenAI).
Aucune des deux fuites ne vient d'un WHERE qui aurait oublié le client. L'une est dans la couche de stockage, l'autre dans un pool de connexions. Gardez-les en tête : à la fin de l'article, vous saurez quelles parties d'une architecture multi-tenant les auraient attrapées, et lesquelles non.
Ce que « multi-tenant » veut dire
Un tenant, c'est un client : une entreprise, un espace de travail, une boutique. Un système multi-tenant sert beaucoup de clients depuis un seul déploiement et, le plus souvent, une seule base de données. L'alternative, un déploiement par client, est la façon dont le logiciel d'entreprise s'est vendu pendant des décennies, et une partie se vend encore ainsi.
Tout le sujet tient en une phrase : un client, une frontière. Chaque question d'architecture revient à savoir où vit cette frontière (infrastructure, base, schéma, ligne, code applicatif), quelle couche la fait respecter, et qui peut contourner cette couche.
Les trois modèles
L'industrie s'est mise d'accord sur des noms. AWS parle de silo, bridge et pool (SaaS Tenant Isolation Strategies). Le guide Microsoft pour Azure SQL parle d'application autonome, de base par client et de base multi-tenant shardée (Multitenant SaaS patterns). Ce sont les trois mêmes formes.
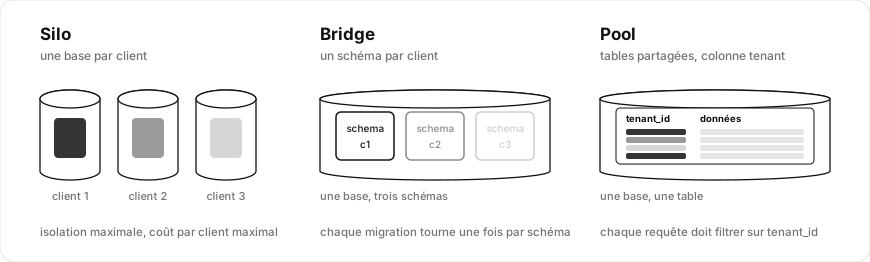
Silo : une base par client. L'isolation la plus forte qu'un moteur de base de données puisse offrir. Restaurer un client à hier 14 h, c'est restaurer une base. Déplacer un client dans la région de son choix, c'est déplacer une base. Le prix est opérationnel : chaque migration tourne une fois par client, chaque index existe une fois par client, et un petit client coûte autant qu'un gros à faire tourner, sauf si la plateforme mutualise les ressources. L'exemple de Microsoft : mille clients avec vingt index chacun, c'est vingt mille index à gérer.
Bridge : un schéma par client, dans une base partagée. Les tables sont dupliquées par client à l'intérieur d'une même base, ce qui donne un espace de noms propre sans le coût d'une base complète. Cela ressemble au meilleur des deux mondes. La section suivante explique pourquoi les équipes qui l'ont exploité à grande échelle l'ont abandonné.
Pool : tables partagées, une colonne tenant sur chaque ligne. Les lignes de tous les clients vivent dans les mêmes tables, distinguées par un tenant_id. Le moins cher par client, le plus simple à migrer, et le modèle qui monte le plus facilement à des millions de petits clients dans des tables partagées. Le coût : aucune frontière physique ne sépare les clients. L'isolation doit être une politique explicite, appliquée dans l'application, dans la base, ou idéalement les deux. Le tableau comparatif de Microsoft le dit sans détour : l'isolation est « basse » dans le modèle multi-tenant shardé, et la base se surveille en bloc, parce que la plateforme ne voit pas ce que consomme chaque client.
Le même tableau place l'échelle à « 1 à des centaines » de clients pour l'application autonome, « 1 à des centaines de milliers » pour la base par client et « 1 à des millions » pour le multi-tenant shardé. Personne ne sert un million de clients avec un million de bases. Microsoft documente aussi un modèle hybride : chaque base porte la colonne tenant et peut loger plusieurs clients, mais certaines n'en logent qu'un, si bien qu'un client en essai gratuit vit dans une base partagée et qu'un client premium peut être déplacé vers une base à lui sans changement de schéma. Le choix n'est pas définitif, et il n'a pas à être le même pour tous les clients.
Ce que les gros produits font vraiment
J'ai lu les blogs d'ingénierie de six entreprises pour répondre à une seule question : à grande échelle, quel modèle survit ? La réponse est le pool, shardé, avec une couche de routage qui sait où vit chaque client.
Slack a démarré comme une application LAMP avec MySQL shardé par espace de travail : toutes les données d'un workspace sur un shard, et un cluster de métadonnées qui associe chaque workspace à son shard. À l'automne 2016, la flotte traitait des centaines de milliers de requêtes par seconde sur des milliers d'hôtes, et le modèle craquait. Les gros clients remplissaient le plus gros matériel disponible. Quelques équipes d'entreprise créaient des points chauds pendant que le reste de la flotte dormait. Enterprise Grid et Slack Connect, où un canal est partagé entre plusieurs workspaces, ont cassé l'hypothèse « les données d'une équipe tiennent sur un shard ». Slack est passé à Vitess entre 2017 et fin 2020, en reshardant les messages par identifiant de canal plutôt que par workspace. Le billet rapporte 2,3 millions de requêtes par seconde en pic, une latence médiane de 2 ms, un p99 de 11 ms, et Vitess déployé dans six régions pour la résidence des données (Scaling Datastores at Slack with Vitess).
Slack, capture de slack.com prise en octobre 2026. Les détails techniques ci-dessus viennent du billet cité, pas de cette page.
Notion a shardé Postgres par workspace_id en 2021, parce que chaque bloc appartient à un seul workspace et qu'un utilisateur travaille dans un workspace à la fois. Ils ont choisi 480 shards logiques répartis sur 32 bases physiques, quinze par machine, chaque shard logique étant un schéma Postgres avec sa propre copie des tables shardées. Pourquoi 480 ? Parce que « 480 est divisible par beaucoup de nombres », ce qui permet d'ajouter des machines par petits paliers au lieu de doubler. Le déclencheur n'était pas le stockage mais VACUUM qui calait, avec le risque de wraparound des identifiants de transaction (Herding elephants). En 2023, ils sont passés de 32 à 96 machines sans interruption observée, par réplication logique, lectures « dark » et bascule base par base répétée en préproduction. Le CPU et les IOPS en pic sont tombés de plus de 90 % à environ 20 % (The Great Re-shard). Notez ce que sont les schémas ici : des shards, pas des clients. Quinze schémas par machine, puis cinq, chacun contenant des milliers de workspaces.
Notion, capture de www.notion.com/product prise en octobre 2026. Les détails techniques ci-dessus viennent du billet cité, pas de cette page.
Shopify fonctionne en pods. « Un pod est un ensemble de boutiques qui vivent sur un ensemble de datastores entièrement isolé », et un composant nommé Sorting Hat, dans les load balancers, marque chaque requête avec son pod, de sorte qu'une requête ou un job de fond ne touche jamais qu'un seul pod (A Pods Architecture). À l'intérieur, la clé de sharding est shop_id, présente sur chaque table appartenant à une boutique. Déplacer une boutique d'un shard à l'autre est une opération de routine : Ghostferry copie ses lignes par lots en suivant le binlog MySQL, puis une courte bascule sous verrou Redis met à jour la table de routage. Avant rééquilibrage, l'usage de la base variait de presque 4× entre shards ; après, d'environ 2× (Shard balancing). À SREcon 2019, deux ingénieurs de Shopify ont décrit le déplacement du jeu de données complet de plus de 800 000 clients vers le cloud avec cet outillage, en ligne (USENIX).
Shopify, capture de www.shopify.com prise en octobre 2026. Les détails techniques ci-dessus viennent du billet cité, pas de cette page.
Figma a multiplié son empreinte Postgres par près de 100 entre 2020 et 2024, d'une base unique sur la plus grosse instance RDS à une douzaine de bases partitionnées verticalement, puis au sharding horizontal. Il a fallu environ neuf mois pour livrer la première table shardée horizontalement, en septembre 2023. Deux idées portent la conception. Les « colos » sont des groupes de tables qui partagent une clé de sharding et un placement physique, si bien que jointures et transactions fonctionnent tant qu'elles restent sur une clé. DBProxy est un service Go qui analyse chaque requête, détermine les shards concernés, et soit la route vers un seul shard, soit la diffuse et agrège ; l'équipe a choisi un langage de requêtes qui couvre les 90 % les plus courantes et refusé le reste. Les clés sont UserID, FileID et OrgID, hachées pour éviter les points chauds (How Figma's databases team lived to tell the scale).
Figma, capture de www.figma.com prise en octobre 2026. Les détails techniques ci-dessus viennent du billet cité, pas de cette page.
Salesforce est le plus ancien et le plus étrange. Force.com ne crée aucune table pour ses clients. Des tables de métadonnées (Objects, Fields) décrivent les objets de chaque organisation, et toutes les données applicatives atterrissent dans une grande table Data dont chaque ligne porte un GUID, un OrgID et un ObjID, suivis de colonnes « flex » Value0 à Value500, toutes en chaîne de longueur variable, pour qu'un champ de n'importe quel type tienne dans n'importe quel emplacement. Index, unicité et relations passent par des tables pivots, et l'ensemble est physiquement partitionné par OrgID. L'optimiseur de requêtes tient des statistiques par client, parce que, comme l'écrit le document, les statistiques classiques « ne tiennent pas compte des caractéristiques d'accès aux données d'un utilisateur donné dans un environnement multi-tenant » (The Force.com Multitenant Architecture, livre blanc).
Salesforce, capture de www.salesforce.com prise en octobre 2026. Les détails techniques ci-dessus viennent du billet cité, pas de cette page.
Atlassian écrit sur sa page de confiance que « chaque shard contient les données de plusieurs clients, mais les données de chaque client sont isolées et inaccessibles aux autres », qu'il a choisi d'isoler microservices et données « plutôt que de fournir une infrastructure dédiée par client », et que tout accès aux données dans Jira et Confluence exige un contexte de tenant fourni par un Tenant Context Service. La résidence des données est proposée dans 11 régions (Cloud architecture and operational practices). L'équipe de la plateforme Jira ajoute que les clients sont répartis en déploiements, chaque copie d'un service servant un sous-ensemble de clients, et que le cache des permissions est cloisonné par tenant (How we unlocked performance at scale).
Jira, capture de www.atlassian.com/software/jira prise en octobre 2026. Les détails techniques ci-dessus viennent du billet cité, pas de cette page.
Six entreprises, un seul schéma : une clé de tenant sur chaque ligne, une table qui associe chaque client à son shard, et un outil pour déplacer un client sans interruption. Le silo n'existe à cette échelle que comme offre commerciale : Atlassian le vend sous le nom d'Isolated Cloud.
Pourquoi pas un schéma par client
Le modèle bridge est celui par lequel beaucoup d'équipes Rails et Django commencent, et Influitive, la société derrière la gem Apartment, en a écrit le post-mortem. Avec un schéma par client, l'ajout d'une colonne, qui devrait être en O(1), devient en O(N) du nombre de clients, et l'ajout d'un index est « bien pire ». Chaque processus Ruby montait à environ 500 Mo de mémoire dès la connexion, parce que le client charge la copie des mêmes tables de chaque schéma. Chaque schéma a ses propres séquences, donc chaque client a un utilisateur avec id = 1, et tout rapport ou export inter-clients casse. Leur conclusion : « abandonner pour l'essentiel l'approche par schémas séparés » et passer les nouveaux services à une colonne tenant (Our Multi-tenancy Journey with Postgres Schemas and Apartment).
Citus a ajouté le sharding par schéma dans sa version 12 (juillet 2023), où chaque schéma devient un shard logique placé sur un nœud, et son annonce nomme elle-même le compromis : « devoir gérer beaucoup de tables, et une surcharge de performance » (Citus 12). Cela convient à un petit nombre de gros clients, ou à un produit qui ajoute la tenancy à un schéma existant. Pas à des milliers de petits.
Pourquoi pas une base par client, et quand il le faut
Le silo connaît un retour, porté par des plateformes qui rendent les bases bon marché. Azure SQL gère « bien plus de 100 000 bases » avec indexation automatique et restauration base par base (Microsoft). Cloudflare D1 autorise 50 000 bases par compte sur une offre payante, limite chacune à 10 Go, et sa propre documentation recommande des « bases par utilisateur, par client ou par entité » (limites D1). Turso a construit son produit sur la même idée, avec SQLite.
Quand c'est le bon choix : peu de clients à forte valeur, un régulateur qui exige une frontière physique, une résidence des données promise client par client, ou un client qui a besoin de sa propre restauration à un instant donné. Les coûts ne disparaissent pas : pas de requête inter-clients sans pipeline analytique séparé, une migration de schéma par base, et, sur les plateformes SQLite, un seul écrivain par base.
Les huit endroits où l'isolation casse
Voici la partie promise par le titre. Dans le modèle pool, l'isolation n'est pas une propriété de la base de données. C'est une propriété de chaque chemin qui touche la base, et de quelques garanties que la base peut tenir pour vous si on les lui demande. Voici le trajet d'une requête, et le badge qu'elle doit porter à chaque étape.
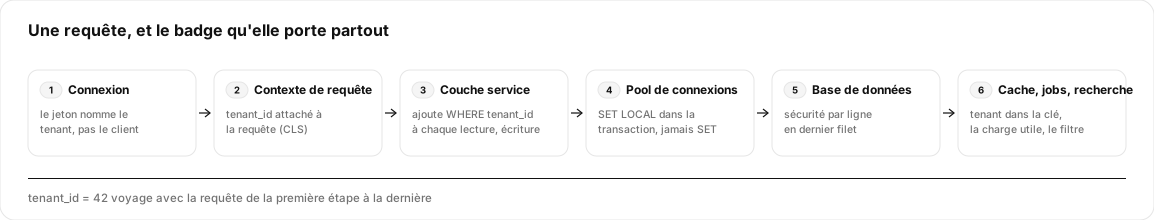
J'ai passé deux ans sur Ever Gauzy, une plateforme de gestion d'entreprise open source construite avec NestJS, Angular et PostgreSQL, où chaque entité étend une TenantBaseEntity avec une colonne tenantId et chaque service étend un TenantAwareCrudService qui fusionne le tenant du contexte de requête dans chaque filtre. La plupart de ce qui suit, je l'ai appris en le corrigeant.
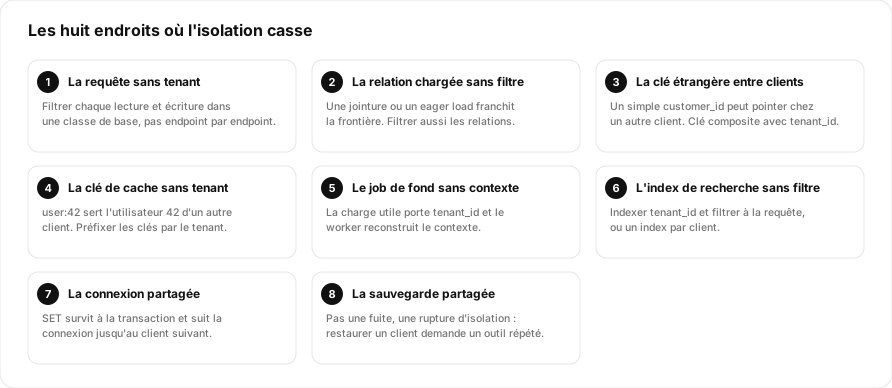
1. La requête qui a oublié le tenant. Le classique. Un endpoint écrit un vendredi interroge par clé primaire sans filtre de tenant, et n'importe quel client qui devine un identifiant lit l'enregistrement d'un autre. Le remède est structurel, pas une liste à cocher en revue de code : mettre le filtre de tenant dans une classe de base par laquelle passent toutes les lectures et écritures, et rendre le dépôt brut difficile d'accès. Dans Gauzy, cette classe lit le tenant depuis un contexte de requête stocké en continuation-local storage, si bien que le service n'a pas besoin que l'appelant le lui passe.
2. La relation chargée sans filtre. La requête est bien filtrée, mais elle charge project.members en eager loading, et la table des membres, elle, ne l'est pas. Ou un filtre imbriqué comme where: { project: { id } } laisse l'appelant choisir un projet qui ne lui appartient pas. J'en ai corrigé deux dans Gauzy (#8961, #9014), en filtrant les relations à travers une carte de permissions déclarée plutôt qu'en faisant confiance à la forme de la requête. Les relations franchissent les frontières en silence ; traitez chacune comme une requête à part entière.
3. La clé étrangère qui traverse les clients. Les lectures peuvent être parfaitement filtrées et les données fausses quand même. Si orders référence customers par customer_id seul, rien n'empêche une ligne du client A de pointer vers un client du client B : la référence est valide pour la base, et elle a été créée par un bug ou par une requête forgée. Le remède est une clé étrangère composite, (tenant_id, customer_id) qui référence customers (tenant_id, id), pour que la base elle-même refuse une référence entre clients. Cela coûte une clé unique composite sur la table parente, et rien d'autre. Citus demande la même forme entre tables distribuées co-localisées : « toujours inclure la colonne de distribution dans la clé » (Citus, modification des tables).
4. La clé de cache sans tenant. user:42 est une très bonne clé jusqu'au jour où deux clients ont chacun un utilisateur 42. Préfixez chaque clé par le tenant, et quand vous mettez en cache une réponse entière, faites du tenant une partie de ce qui identifie la réponse. La plateforme Jira d'Atlassian cloisonne son cache de permissions par tenant exactement pour cette raison. L'incident OpenAI se situe une couche en dessous de la clé : le bug renvoyait les octets d'une autre connexion, aucun schéma de clés n'aurait aidé. La défense, là, c'est de vérifier la charge utile à la sortie, j'y reviens à la fin.
5. Le job de fond sans contexte. Le contexte lié à la requête meurt avec elle. Un job repris par un worker n'a aucun tenant, sauf si la charge utile le porte et que le worker reconstruit le contexte avant de toucher la base. Le symptôme révélateur : un cron qui « nettoie les éléments expirés » de tous les clients d'un coup, c'est-à-dire une requête inter-clients par construction, écrite par quelqu'un qui a oublié qu'elle l'était.
6. L'index de recherche sans filtre. Elasticsearch, Meilisearch, pgvector : chacun est un second datastore avec sa propre notion de ligne. Soit chaque document porte le tenant et chaque requête filtre dessus, soit il y a un index par client. L'index de recherche des tickets d'Atlassian est shardé par tenant et par projet.
7. La connexion partagée. Celui-ci est propre à Postgres et aux poolers, et c'est le plus subtil. La façon habituelle de passer le tenant à la sécurité par ligne est une variable de session, SET app.tenant_id = '42'. PgBouncer en mode transaction n'attribue une connexion serveur à un client « que pendant une transaction », et sa documentation marque SET et RESET comme ne fonctionnant jamais dans ce mode (PgBouncer features). Un SET simple survit au commit, suit la connexion dans le pool, et le client suivant hérite de la variable du client 42. Le remède est dans le manuel Postgres : « les effets de SET LOCAL ne durent que jusqu'à la fin de la transaction courante, validée ou non » (SET). Toujours SET LOCAL, toujours dans une transaction explicite. Et la valeur posée doit venir de l'identité authentifiée, jamais d'un corps de requête, d'un paramètre d'URL ou d'un en-tête. Une policy applique le tenant que l'application lui donne ; donnez-lui le mauvais et RLS appliquera le mauvais, fidèlement.
8. La sauvegarde partagée. Celle-ci n'est pas une fuite de confidentialité mais une rupture d'isolation, et elle a sa place dans la liste. La panne d'Atlassian d'avril 2022 est le cas de référence. Un script censé supprimer une application héritée a été lancé avec des identifiants de sites au lieu d'identifiants d'application, et l'API acceptait les deux sans vérifier. Entre 07:38 et 08:01 UTC, il a supprimé 883 sites appartenant à 775 clients. Les données étaient dans les sauvegardes. Le problème, c'est qu'Atlassian n'avait aucun moyen de restaurer un sous-ensemble de clients depuis des stockages partagés par beaucoup d'autres ; la première méthode de restauration demandait environ 70 étapes et 48 heures par lot, la seconde environ 12 heures par site, et les derniers clients sont revenus le 18 avril (post-mortem). Dans le modèle pool, « nous avons des sauvegardes » n'est pas la même chose que « nous savons restaurer un client ». Le second se construit, et se répète.
Là où un contexte de requête casse dans NestJS
L'approche par classe de base ne tient que tant que le tenant est dans le contexte, et dans une application NestJS il y a quatre endroits où, sans bruit, il n'y est plus.
- La propagation asynchrone. Le contexte vit dans
AsyncLocalStorage, via une bibliothèque commenestjs-cls. Il suit les promesses attendues et les callbacks créés dans la requête, et il s'arrête à tout ce qui tourne sur une autre pile : un timer armé avant la requête, un émetteur d'événements câblé au démarrage, un pool de connexions qui déclenche ses callbacks depuis sa propre boucle. Le travail lancé là n'a pas de tenant. - Les tâches planifiées et les consommateurs. Une méthode
@Cron, un consommateur de file ou un handler WebSocket n'est pas une requête. Dans Gauzy, le service tenant-aware documente la conséquence en une ligne : quand aucun utilisateur n'est disponible dans le contexte de requête, « il se comporte exactement comme » le service CRUD ordinaire, c'est-à-dire sans filtre. C'est le comportement honnête, et c'est aussi exactement la forme d'une fuite. Un worker doit ouvrir lui-même un contexte, depuis le tenant porté par la charge utile du job, avant de toucher un dépôt. - L'accès direct aux dépôts. Tout ce qui atteint directement le
DataSourcede TypeORM ou unQueryBuildercontourne le service et son filtre. La classe de base n'est solide que par la règle qui garde les dépôts bruts hors des modules fonctionnels, et c'est une règle de revue de code, pas un type. - Les transactions. Une transaction ouverte avec
dataSource.transaction()distribue son propre entity manager. Les requêtes construites dessus doivent remettre le tenant ; rien n'en hérite.
Aucun de ces points n'est un argument contre la classe de base. Ce sont les raisons pour lesquelles la base de données a besoin de son propre filtre.
La sécurité par ligne : ce que Postgres promet exactement
La sécurité par ligne (row-level security, RLS) laisse la base faire respecter le filtre de tenant : une requête qui l'oublie ne renvoie rien au lieu de tout. C'est la bonne deuxième ligne. Ce n'est pas une première ligne, et le manuel est précis sur ses limites (Row Security Policies) :
- « Les superutilisateurs et les rôles dotés de l'attribut
BYPASSRLScontournent toujours le système de sécurité par ligne. » L'application doit donc se connecter avec un rôle qui n'est ni l'un ni l'autre, et les migrations tourner avec un autre rôle. - « Les propriétaires de tables contournent normalement la sécurité par ligne eux aussi », sauf si la table reçoit
FORCE ROW LEVEL SECURITY. Si le rôle applicatif possède les tables, RLS ne fait rien pour lui. - RLS activé sans policy, « une politique de refus par défaut s'applique ». L'activer est sûr par défaut ; oublier une policy fait disparaître une table plutôt que la faire fuir.
- Les expressions de policy sont évaluées « avant toute condition ou fonction venant de la requête de l'utilisateur ». La seule exception concerne les fonctions marquées
leakproof, garanties ne divulguer aucune information par leurs arguments ou leurs erreurs ; le planificateur peut les exécuter avant le filtre. Une fonction ordinaire, y compris celle que vous avez écrite, s'exécute après le filtre et ne voit jamais une ligne cachée. La règle existe précisément pour fermer le canal des messages d'erreur. - Les contrôles d'intégrité référentielle « contournent toujours la sécurité par ligne », et le manuel met en garde contre les fuites par « canal caché » via les clés étrangères : une insertion qui référence une ligne cachée par la policy réussit quand même, ce qui révèle que la ligne existe.
Supabase, qui met RLS devant chacun de ses clients, publie les règles d'exploitation qui le rendent rapide et sûr : un index btree sur chaque colonne filtrée par une policy, les appels d'aide enveloppés en (select auth.uid()) pour que Postgres les évalue une fois par requête et non une fois par ligne, security_invoker = true sur les vues pour qu'elles ne contournent pas les policies des tables, search_path = '' dans les fonctions security definer, et une suite de tests qui vérifie le cas de refus pour chaque rôle et chaque opération, pas seulement le cas d'autorisation (guide RLS de Supabase). La clé service_role contourne RLS et ne quitte jamais le serveur.
La combinaison qui tient : l'application filtre par tenant à un seul endroit, RLS filtre une seconde fois avec SET LOCAL dans une transaction, et une suite de tests négatifs s'exécute avec le rôle applicatif et vérifie que les lignes d'un autre client reviennent à zéro.
Voici l'ensemble, assez court pour tourner dans psql. La table porte le tenant dans sa clé primaire, la policy filtre les lectures avec USING et les écritures avec WITH CHECK, le propriétaire est filtré lui aussi, et le rôle applicatif ne possède rien.
CREATE TABLE orders (
  tenant_id uuid    NOT NULL,
  id        uuid    NOT NULL DEFAULT gen_random_uuid(),
  total     numeric NOT NULL,
  PRIMARY KEY (tenant_id, id)
);

ALTER TABLE orders ENABLE ROW LEVEL SECURITY;
ALTER TABLE orders FORCE ROW LEVEL SECURITY;   -- le propriétaire est filtré aussi

-- current_setting(..., true) renvoie NULL quand rien n'est posé : refus par défaut.
CREATE POLICY orders_by_tenant ON orders
  USING      (tenant_id = current_setting('app.tenant_id', true)::uuid)
  WITH CHECK (tenant_id = current_setting('app.tenant_id', true)::uuid);

CREATE ROLE app_user LOGIN NOBYPASSRLS;        -- ne possède rien, ne contourne rien
GRANT SELECT, INSERT, UPDATE, DELETE ON orders TO app_user;
Et les deux tests, exécutés en app_user, avec le client A posé depuis la session vérifiée. Le premier prouve que A ne peut pas modifier une ligne de B : la mise à jour ne touche rien. Le second prouve que A ne peut pas écrire une ligne chez B : WITH CHECK la rejette.
BEGIN;
SET LOCAL app.tenant_id = '11111111-1111-1111-1111-111111111111';   -- client A

UPDATE orders SET total = 0
 WHERE id = '<un identifiant de commande du client B>';
-- UPDATE 0 : la ligne est invisible pour A, il n'y a rien à modifier

INSERT INTO orders (tenant_id, total)
VALUES ('22222222-2222-2222-2222-222222222222', 10);                 -- client B
-- ERROR:  new row violates row-level security policy for table "orders"
COMMIT;
Mettez les deux dans la suite de tests, exécutez-les avec le rôle applicatif à travers le même pooler qu'en production, et la policy est testée telle qu'elle sera utilisée.
Le voisin bruyant
L'isolation, c'est aussi la performance. Dans un pool, l'import en masse d'un client se dispute le même CPU, les mêmes IOPS et les mêmes connexions que le paiement de tous les autres. Shopify a mesuré un écart de 4× d'usage de base entre shards avant rééquilibrage. Le re-shard de Notion en 2023 a été déclenché par des shards au-delà de 90 % de CPU en pic pendant que d'autres dormaient, et répartir la charge sur trois fois plus de machines a révélé des workspaces « hors norme » qui consommaient une part disproportionnée. Atlassian répartit ses clients en déploiements pour qu'un incident reste dans un shard.
La leçon est opérationnelle : pouvoir déplacer un client d'un shard à un autre n'est pas une fonctionnalité de montée en charge, c'est la manière d'isoler un gros client un mardi après-midi. Ghostferry chez Shopify, le resharding de Vitess et l'outil split/merge de Microsoft existent pour cela. L'outil de Microsoft a une exigence qui mérite d'être adoptée dès le premier jour : l'identifiant du tenant doit être l'élément de tête de la clé primaire de chaque table shardée, pour que les lignes d'un client se retrouvent et se déplacent vite.
Si je lançais un SaaS aujourd'hui
- Modèle pool, un
tenant_idsur chaque ligne appartenant à un client, et des clés étrangères composites qui le portent. Mettez le tenant en tête de la clé primaire des tables que vous pourriez sharder un jour, c'est ce qu'exige l'outil split/merge de Microsoft ; les tables globales comme les pays ou les devises n'en ont pas besoin. Ça coûte peu le premier jour et ça garde toutes les évolutions possibles : sharder par client, déplacer un client, promouvoir un client vers sa propre base. - Une seule couche de filtrage par laquelle passe chaque requête, alimentée par un contexte de requête, avec le dépôt brut hors de portée. Les relations et les filtres imbriqués passent par elle aussi.
- RLS en deuxième ligne, avec un rôle applicatif qui ne possède rien et ne peut rien contourner,
SET LOCALdans une transaction, et des index sur chaque colonne de policy. - Le tenant dans chaque clé, charge utile et filtre : clés de cache, messages de file, documents de recherche, chemins de stockage objet, lignes de logs.
- Une suite de tests négatifs qui tourne avec le rôle applicatif et prouve que les lignes d'un autre client sont invisibles, pour chaque opération.
- Une restauration d'un seul client, répétée, avant que le premier client la demande.
- Un plan pour le jour où un client a besoin d'un silo : une région, une base dédiée, une offre. Shopify déplace une boutique ; Atlassian vend Isolated Cloud ; il vous faut une réponse aussi.
Retour aux deux fuites
Ce plan les aurait-il attrapées ? La fuite de Cloudflare était sous chaque élément de la liste : un pool de stockage qui réutilisait des blocs sans les remettre à zéro. Aucune colonne tenant, aucune RLS, aucune clé de cache n'atteint cette couche. Wiz, la société derrière les découvertes ChaosDB et ExtraReplica, a construit un cadre pour exactement cette question. Sa cause racine pour toute la famille est « des frontières de sécurité mal implémentées », et l'une des premières questions de sa revue d'isolation est de savoir si une interface exposée aux clients est partagée ou dupliquée par client (PEACH). Un pool de blocs partagé est une interface partagée, et on lui a fait confiance.
La fuite d'OpenAI se trouvait dans le pool de connexions, une couche sous la clé de cache. La seule défense applicative qui aurait fonctionné est celle que la plupart des systèmes sautent : quand un enregistrement revient d'un cache ou d'une bibliothèque cliente, vérifier que son tenant correspond au tenant de la requête avant de s'en servir. OpenAI a fait exactement cela après l'incident ; son rapport liste, parmi les actions prises, des « contrôles redondants pour s'assurer que les données renvoyées par notre cache Redis correspondent à l'utilisateur qui les demande ». C'est peu coûteux, ça attrape le cas courant où un enregistrement entier revient pour le mauvais utilisateur, et ça transforme cette fuite en erreur. Ce n'est pas une garantie contre toutes les façons dont une bibliothèque cliente peut corrompre des données, seulement contre celle qui fuit.
C'est la version honnête du « zéro fuite » : chaque couche filtre à l'entrée, et l'application vérifie à la sortie, parce qu'une des couches est toujours le code de quelqu'un d'autre.
Sources
- Cloudflare, How Cloudflare addressed a cross-tenant data exposure vulnerability in Containers, septembre 2026 ; InfoQ, Cloudflare Fixes Cross-Tenant Data Exposure in Containers, octobre 2026.
- OpenAI, March 20 ChatGPT outage: Here's what happened, mars 2023.
- AWS, SaaS Tenant Isolation Strategies.
- Microsoft Learn, Multitenant SaaS patterns for Azure SQL Database, mis à jour en août 2025.
- Slack Engineering, Scaling Datastores at Slack with Vitess, décembre 2020.
- Notion, Herding elephants: lessons learned from sharding Postgres at Notion, 2021, et The Great Re-shard, juillet 2023.
- Shopify Engineering, A Pods Architecture To Allow Shopify To Scale, mars 2018, et Shard Balancing: Moving Shops Confidently with Zero-Downtime at Terabyte-scale.
- USENIX SREcon19 EMEA, Zero-Downtime Rebalancing and Data Migration of a Mature Multi-Shard Platform, Justin Li et Florian Weingarten, Shopify.
- Figma, How Figma's databases team lived to tell the scale, mars 2024.
- Salesforce, The Force.com Multitenant Architecture, livre blanc, 2008.
- Atlassian, Cloud architecture and operational practices ; How We Unlocked Performance at Scale with Jira Platform, décembre 2025 ; Post-Incident Review on the April 2022 outage.
- Influitive, Our Multi-tenancy Journey with Postgres Schemas and Apartment.
- Citus Data, Citus 12: Schema-based sharding for PostgreSQL, juillet 2023.
- Cloudflare, D1 limits.
- Documentation PostgreSQL, Row Security Policies et SET.
- PgBouncer, Features.
- Supabase, Row Level Security.
- Vitess, Vindexes.
- Wiz, PEACH: a tenant isolation framework for cloud applications.
- Ever Gauzy, TenantAwareCrudService, et les pull requests #8961 et #9014.